Los medios construyeron la mejor biblioteca del mundo. Olvidaron ponerle llave.
En su mejor época Inglaterra tenía más de mil periódicos locales. No es difícil imaginar que una mañana, en uno de ellos, un empleado llegue como es habitual, salude a sus compañeros, rían un rato, y luego, una vez acomodado en su escritorio, hable con su editor sobre lo que debe cubrir. Esa mañana en el monitor, Logan Kilpatrick, jefe de producto de Google, responde en X a un usuario sobre si el AI Mode será por defecto el nuevo buscador. La respuesta es una sola palabra: «Soon». Este empleado jamás hubiera imaginado que esa noticia impactaría tanto en su vida.
Tiempo después el escritorio está vacío. El hombre, ahora desarreglado, bebe, en un bar lleno de cuadros nostálgicos, un sorbo de café, mientras lee uno de los pocos diarios a papel que sobreviven.
El Reuters Institute junto con la Universidad de Oxford publican cada año el Digital News Report, un estudio de referencia global sobre consumo de noticias. Para la edición 2026 analizaron 27 mercados hallando un dato interesante: apenas el 4% de los encuestados dice hacer clic «siempre o a menudo» en las fuentes originales cuando se informa por chatbots de IA.
En Argentina ese 4% se mantiene, en España desciende al 3% mientras que en el Reino Unido ese número cae al 1%. Entre las plataformas analizadas (buscadores 19%, redes sociales 17%, en el conjunto de los 27 mercados), los chatbots son los que registran menos clics hacia la fuente, aunque el informe lo atribuye en buena medida a que todavía son pocos los que los usan para informarse. El periodismo sigue siendo consumido, pero sin ser visitado.
La búsqueda menos pensada
La búsqueda de audiencias y la necesidad de alimentar algoritmos incentivaron a las redacciones a adoptar la infinidad de herramientas buscando formas, cada vez más sofisticadas, de distribuir y presentar información. Lo que fue una ventaja competitiva hoy es la espada que abre la herida.
Durante años los medios comenzaron a implementar diferentes mecanismos para atrapar a las audiencias, nació la preocupación por el SEO, los titulares de clickbait, los dark patterns (es un mecanismo de retención), y el uso de chatbots personales donde diferentes portales te invitaban a charlar con las notas del medio y todo el contenido digitalizado que el diario había producido.
Ese hermoso recurso donde cada visitante preguntaba y accedía a la base de conocimiento del medio, con la llegada de la IA y los agentes se transformó en otra cosa. Sin quererlo, la idea terminó siendo otra cosa: un acceso organizado, indexado y optimizado para ser consultado por cualquier agente externo que llegue con una pregunta. Cuanto mejor armada la base de conocimiento, más fácil es extraerla.
Esa base de años, y de cantidad de empleados que elaboraron, tras mucho trabajo de campo y horas frente a una pantalla, pronto se convertiría en la materia prima que alimenta a los modelos de lenguaje. Se buscaba audiencias se encontraron bots.
El caso Wayback Machine
La extracción de contenido no es algo nuevo, pero los medios recién ahora comenzaron a prestar atención y poner restricciones. El caso del Wayback Machine es el más ilustrativo. Este portal resguarda la historia de todos los sitios web que existieron. En 2026, más de 340 medios bloquearon su acceso porque el archivo servía — o podía servir — como base de datos para el entrenamiento de nuevos modelos de IA. The Guardian revisó sus logs y encontró que era uno de los crawlers más frecuentes en su sitio. Lo bloqueó.
Pero ese no es el único caso ni mecanismo, la capacidad de los modelos de reconstruir artículos pagos a partir de información dispersa es otro de los desafíos que tienen los medios para trabajar. Henk van Ess, experto en investigación digital, probó en 2025 qué tan bien ChatGPT y Perplexity podían replicar contenido de The Atlantic, el New York Times y el Financial Times sin acceder nunca al contenido pago —el que requiere suscripción para leerlo—. En hasta la mitad de los casos, lo lograron. La IA recopila el tweet, el hilo de Reddit, la newsletter que parafraseó el artículo, y reconstruye el contenido. Sin clic, sin visita, sin huella.
La internet agéntica cambió las reglas de juego. Estos soldados no descansan, solo necesitan las instrucciones correctas y una puerta de entrada. El resto lo toman sin pedir permiso. En marzo de 2025, TollBit registró y bloqueó 26 millones de intentos de extracción no autorizados en sitios de medios en un solo mes. En el mismo período, Cloudflare registró que el tráfico de bots saltó del 3% al 13% en un solo trimestre.
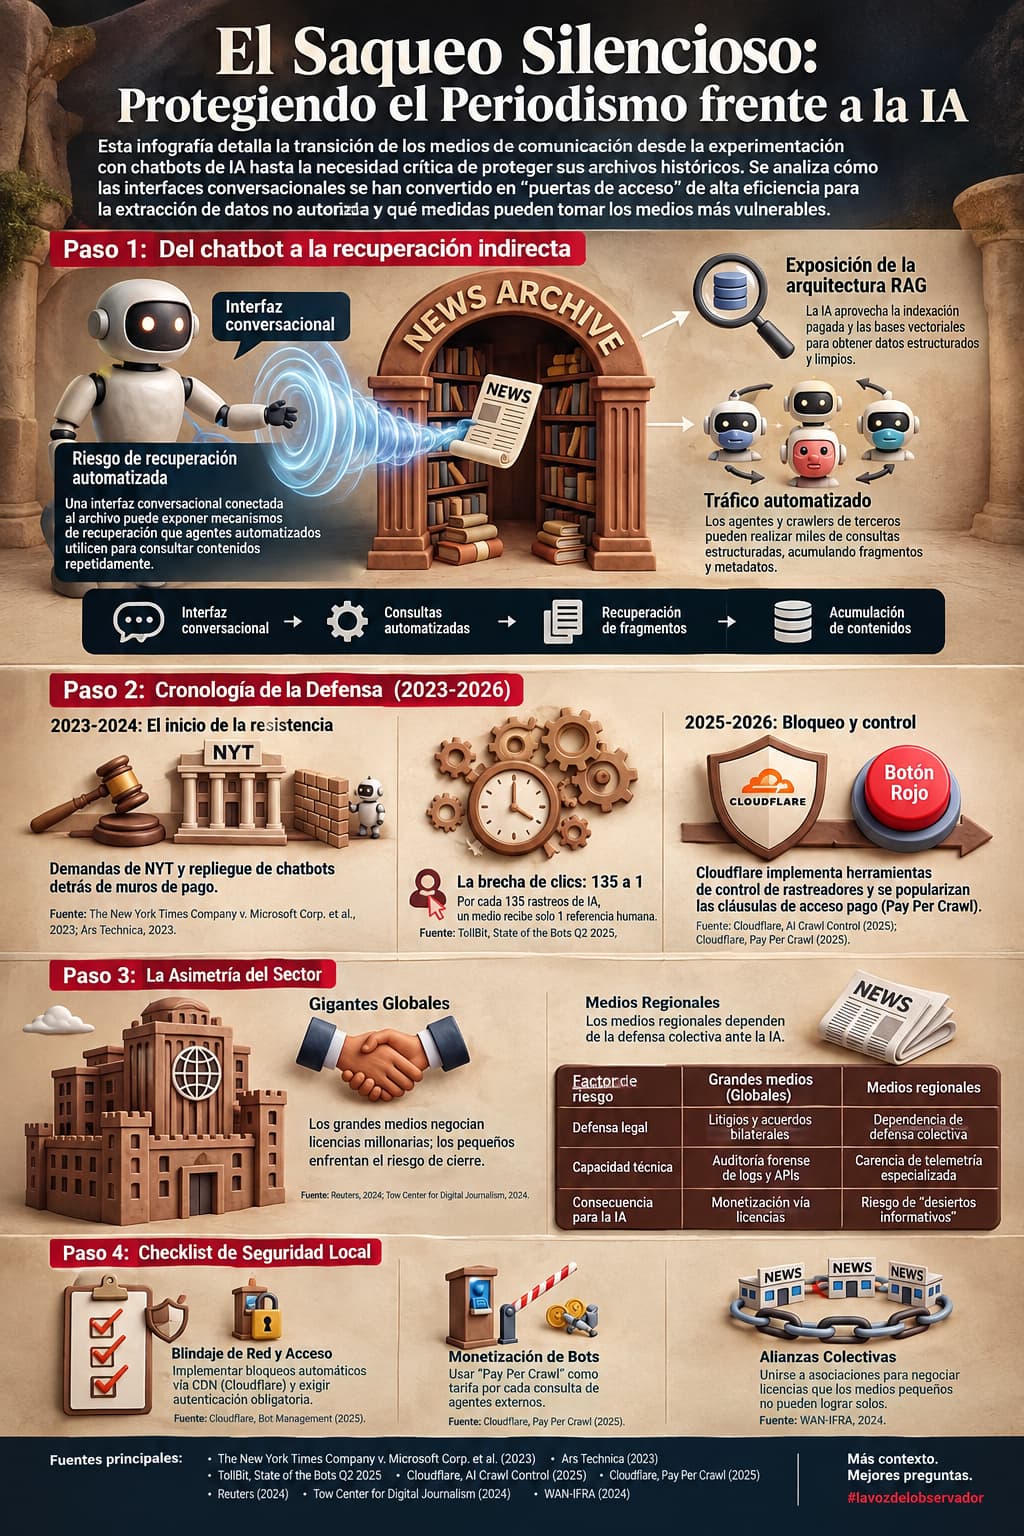
Entonces, todo ese contenido evergreen —explicadores, guías, artículos de referencia diseñados para rankear durante años— hoy puede ser el material que la IA procese, resuma y utilice sin enviar a nadie de vuelta. Cada herramienta adoptada para atraer tráfico terminó alimentando al sistema que los desplazó.
Esta semana el grupo británico Reach, dueño del Daily Mirror, el Daily Express y decenas de sitios regionales, anunció la eliminación de 220 puestos editoriales, el cierre de tres marcas exclusivamente online —KentLive, AberdeenLive y GalwayBeo— y la creación de 60 nuevos roles orientados a suscripciones y video de formato largo. No es un caso aislado. Es el ejemplo más reciente de a dónde lleva ese sistema.
El pacto deshecho
Cualquiera con móvil aprecia que el modo de búsqueda ha cambiado: el resumen es rápido, práctico y limpio. Ya no Googleeamos. Preguntamos.
Las AI Overviews son el cambio más grande en búsqueda desde que se introdujeron los fragmentos destacados en 2014, y están aumentando las búsquedas de cero clics, que ahora representan el 69% de todas las consultas, según Similarweb.
El usuario pregunta, la respuesta aparece en pantalla, y el viaje termina ahí: sin clic, sin visita, sin dato de audiencia que el medio pueda monetizar.
El tráfico siempre fue un medio, no un fin. Lo que importaba era lo que ese tráfico generaba: ingresos publicitarios por programática, datos de comportamiento para perfilar audiencias, y la posibilidad de convertir visitantes en suscriptores o lectores fidelizados. Cuando el tráfico cae, toda esa cadena se rompe. Si se requieren datos o perfilar la audiencia, la dependencia en las plataformas se hace evidente.
Google Zero
En 2024, Nilay Patel, editor en jefe de The Verge, comenzó a utilizar el término «Google Zero» para describir el momento en que Google Search dejara de enviar tráfico a sitios externos. Hoy ese momento parece haber llegado, y algunos editores están considerando directamente bloquear los crawlers de Google de sus sitios. La paradoja es brutal: desindexarse de Google significa perder visibilidad en búsqueda tradicional, pero mantenerse indexado significa alimentar gratis al sistema que te quita el tráfico.
La visión de Sundar Pichai para Google es transformar Search de un motor de recuperación en un gestor de agentes: una plataforma que no solo encuentra información sino que actúa sobre ella, con modelos de IA que interpretan consultas, sintetizan respuestas y ejecutan tareas. La dirección estratégica es clara: Google quiere que los usuarios interactúen con la IA, no con los sitios web.
El problema es que ese modelo de negocio depende de que esos sitios sigan existiendo, produciendo contenido, e invirtiendo en periodismo. El caso Reach muestra con precisión dónde empieza a quebrarse esa lógica. Por otro lado, cuál es el limite de la IA para buscar esa información. Sabemos que cuando damos una orden agentes, harán cualquier cosa con tal de completar su misión.
¿Debe transformarse la web con la llegada de la IA?
Existe dos tipos de bots de IA que hoy visitan los sitios de medios, los primeros rastrean y almacenan contenido para alimentar futuros modelos. Después están los fetcher bots que trabajan diferente: extraen contenido en tiempo real, cuando un usuario hace una pregunta a un asistente, la respuesta se construye en vivo. No forma parte de ninguna base de datos para el futuro. o eso creemos…
Ahora pensá qué pasa cuando un fetcher bot llega a un chatbot periodístico bien construido. No necesita rastrear miles de páginas. El medio ya organizó, indexó y optimizó su archivo para responder preguntas. El chatbot del diario es, técnicamente, un endpoint de recuperación de información. Un agente externo —el de Google, el de ChatGPT, el que el usuario tenga conectado— puede usarlo exactamente como lo usaría un suscriptor: haciéndole preguntas.
Un fetcher bot no espera que abras la puerta, captura el valor en el momento en que alguien dispara la pregunta, luego lo entregan, de tal forma que los usuarios no necesitan visitar el sitio. Para los medios con modelo de publicidad programática, eso no es una tendencia a monitorear: es un problema estructural de ingresos. Según un análisis de TollBit sobre 160 sitios web, con datos de fines de 2024, las referencias desde buscadores de IA generaban cerca de un 96% menos de tráfico que Google. Y un estudio de Pew Research Center encontró que, cuando Google muestra un resumen generado por IA, los usuarios hacen clic en los enlaces dentro del resumen en el 1% de las visitas.
Que el contenido periodístico es de valor para las IA no es un cuento: el New York Times demandó a OpenAI, el Financial Times negoció un acuerdo de licenciamiento, y Axel Springer, la Associated Press, Le Monde y El País hicieron lo mismo. Todos llegaron a la misma conclusión por caminos distintos: si no ponés un precio, alguien más se queda con el valor. Pero qué valor puede poner un medio chico o independiente.
Cuando no hay quien cubra esas historias, el AI Mode va responderlas, pero con información genérica o sin la actualizacion correspondiente, no olvidemos, la inteligencia artificial jamás va a admitir que no sabe.
Cuando un diario local cierra, esa cobertura no migra a otro lado. Desaparece.
En el Reino Unido ya existe un nombre para lo que queda: news deserts, zonas sin periodismo local, donde las decisiones que afectan la vida cotidiana de miles de personas se toman sin que nadie las registre, las cuestione ni las cuente.
Cada vez que preguntamos a una IA un enjambre de agentes se dispara en búsqueda de información. Nada les impide apropiarse de la miel que cada medio fabricó en su portal. La mayoría de quienes reciben una respuesta de IA no pasa por el medio que produjo la información, y muchos medios construyeron esa colmena sin saberlo.
La pregunta que queda no es si los medios van a sobrevivir. Es qué pasa con la conversación pública cuando el noticiero lo arma un algoritmo.
Aclaración: las imágenes de este sitio son, en su mayoría, ilustraciones generadas con inteligencia artificial, de carácter dramático o editorial, y no documentan hechos reales. Más información.